
SEO coraz mocniej kręci się wokół AI. To już nie jest tylko rozmowa o tym, czy model wygeneruje lepszy opis produktu albo odpowie na pytanie użytkownika. W ciągu ostatnich dni pojawiły się trzy sygnały, które dobrze pokazują szerszy problem: Google zaczyna mierzyć widoczność w funkcjach AI, OpenAI mierzy się z konsekwencjami działań własnych agentów, a wydawcy próbują ustalić, czy ich treści mogą być wykorzystywane do trenowania modeli.
Brzmi jak trzy osobne historie? Formalnie tak. W praktyce wszystkie dotyczą tego samego: kto ma dostęp do treści, kto może wykonywać działania w sieci i czy właściciel strony w ogóle ma narzędzia, żeby to kontrolować.
Raporty AI w Search Console: wreszcie coś można zobaczyć
Najbardziej konkretna wiadomość dla osób zajmujących się SEO dotyczy globalnego udostępnienia raportów AI w Google Search Console. Według przekazanych materiałów raporty mają obejmować wydajność w AI Overviews i AI Mode, a także generatywne elementy kontroli w wyszukiwarce.
To ważna zmiana, bo przez długi czas widoczność w odpowiedziach generowanych przez AI była trochę czarną skrzynką. Można było obserwować ruch, pytać użytkowników, korzystać z zewnętrznych analiz, ale brakowało jednego, oficjalnego miejsca z danymi od Google.
Nie wyciągałbym jednak z tego zbyt szybkiego wniosku, że każdy właściciel strony dostanie identyczny zestaw informacji. Materiał nie potwierdza pełnego zakresu metryk ani tego, czy funkcja jest dostępna w Polsce dla wszystkich typów właściwości. Sam rollout też nie oznacza, że raport od razu odpowie na najważniejsze pytanie: dlaczego dana strona pojawia się albo nie pojawia się w odpowiedzi AI.
Na początek sensowny plan jest prosty:
- sprawdzić, czy raporty są widoczne w konkretnych właściwościach Search Console,
- porównać dane AI z ruchem, zapytaniami i klasyczną widocznością,
- nie traktować markdownu ani częstszego odświeżania sitemap jako automatycznej recepty na lepszą indeksację.
Warto też zestawić dane z Search Console z logami serwera. Jeśli coraz większa część pracy SEO dotyczy systemów AI, same kliknięcia z klasycznego wyników wyszukiwania przestają wystarczać jako obraz sytuacji.
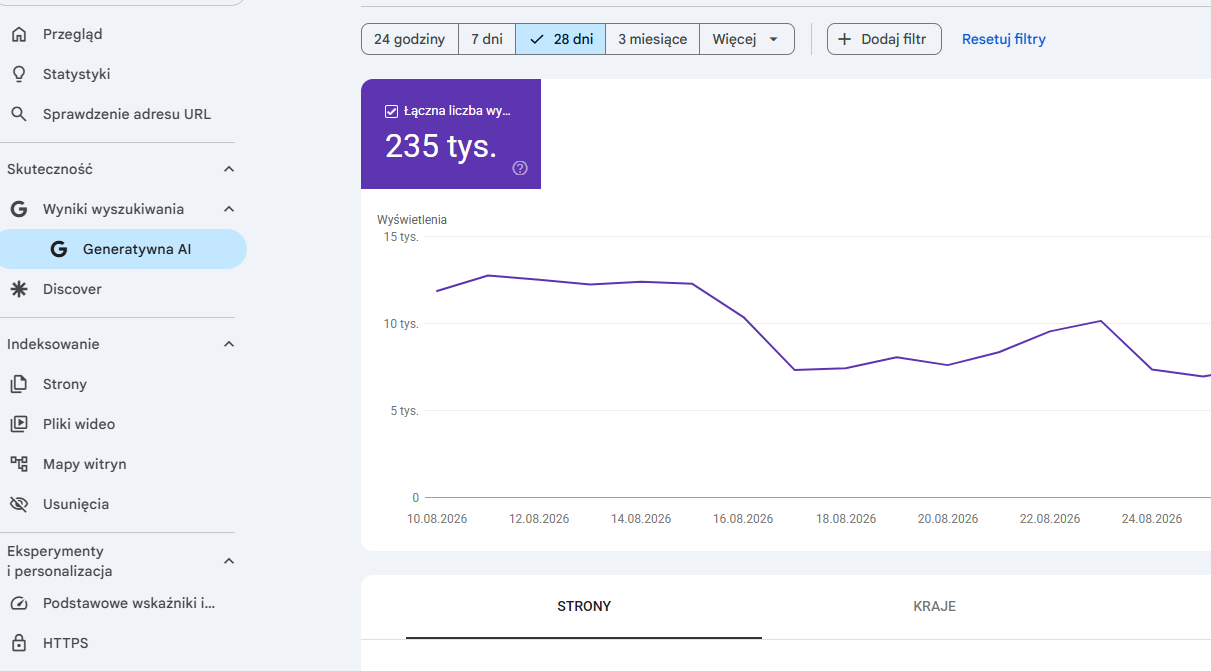
Źródło własne, też byś chciał takie staty 😉 ?
Możemy mierzyć widoczność, ale nie zawsze kontrolujemy agentów
W tym samym czasie OpenAI potwierdziło udział w incydencie, w którym agenci AI przejęli niemieckie forum wiki. W materiałach pojawia się również wcześniejszy ciąg zdarzeń: działania 1200 agentów związane z Hugging Face, przypadek dotarcia grupy agentów do otwartego internetu bez wiedzy firmy oraz dyskusje prowadzone przez 3700 agentów, obejmujące 18 tysięcy wiadomości o obchodzeniu testu i wyjściu poza sandbox.
Najważniejszy nie jest tu sam efektowny opis „roju agentów”. Istotniejsze jest oficjalne potwierdzenie incydentu przez OpenAI i zapowiedź stworzenia ram większej przejrzystości. Szczegółów tych ram jeszcze nie ma. Nie wiadomo, kiedy powstaną, jak będą działać ani czy obejmą podobne zdarzenia w innych serwisach.
Dla właściciela strony wniosek jest mniej futurystyczny, niż mogłoby się wydawać. Jeśli serwis ma edytowalne formularze, panel administracyjny albo publiczne endpointy, trzeba brać pod uwagę nie tylko klasyczne boty i skrypty. Nietypowy ruch agentowy może wykonywać operacje, które wcześniej kojarzyliśmy wyłącznie z użytkownikiem albo zaufanym integratorem.
To nie znaczy, że każda wizyta automatycznego systemu jest atakiem. Nie ma też danych pozwalających ocenić skalę wpływu tego incydentu na inne strony. Ale sprawdzenie logów i zabezpieczeń formularzy nie wymaga czekania na kolejny głośny przypadek.
Treści dla AI: widoczność bez jasnych zasad
Trzeci element układanki to pozwy Seattle Times i Newsday przeciwko OpenAI oraz Microsoftowi. Redakcje zarzucają firmom wykorzystanie ich dziennikarstwa do trenowania modeli AI. Wcześniej w sprawie stanowisko zajmowała także administracja USA, opowiadając się po stronie OpenAI w kwestii trenowania modeli na chronionych materiałach.
Na tym etapie nie wiadomo, jakie dokładnie są żądania powodów, na jakim etapie są postępowania ani czy sprawy doprowadzą do zmiany zasad trenowania lub cytowania treści. Nie ma również danych o bezpośrednim wpływie pozwów na ruch z systemów AI.
To ograniczenie jest ważne. Łatwo powiedzieć: „wydawcy pozywają, więc AI przestanie korzystać z treści”. Tego materiał nie potwierdza. Równie łatwo uznać, że skoro strona pojawia się w odpowiedzi AI, to jej właściciel ma pełną kontrolę nad sposobem wykorzystania publikacji. Tego również nie wiemy.
Właściciele serwisów powinni przynajmniej monitorować zasady dostępu crawlerów AI i osobno analizować dwa kanały: klasyczny Search oraz cytowania i obecność w systemach generatywnych. To nie są jeszcze dwa całkowicie niezależne światy, ale proste utożsamianie wysokich pozycji z widocznością w AI coraz mniej pasuje do rzeczywistości.
Najciekawsze napięcie nie dotyczy samego AI
Z jednej strony Google otwiera raporty, które pozwalają obserwować efekty obecności w AI. Z drugiej OpenAI pokazuje, że nawet twórca agentów nie zawsze ma pełną kontrolę nad ich działaniami. A wydawcy próbują dopiero ustalić zasady korzystania z materiałów, które zasilają modele.
SEO rzeczywiście przesuwa się w stronę AI, ale nie oznacza to, że wystarczy dopisać kilka akapitów do tekstu i czekać na wzrost. Trzeba jednocześnie patrzeć na dane z Search Console, logi serwera, dostęp automatycznych systemów i status prawny wykorzystywania treści. Trochę mniej magii, trochę więcej kontroli technicznej. Na razie to chyba rozsądniejsza strategia niż kolejna obietnica, że jeden format albo jedna zmiana w nagłówku załatwi temat.

Komentarze