
Niedawno pisałem o sporze Google z SerpApi i zastanawiałem się, czy internet przypadkiem nie zmierza w stronę modelu: publiczne dla ludzi, kontrolowane albo płatne dla maszyn. Nie trzeba było długo czekać, żeby Google dorzuciło do tej układanki bardzo ciekawy element.
9 września 2026 roku Google zaktualizowało dokumentację Web Search Service API. Nazwa jest mało ekscytująca, ale to, co znajduje się pod spodem, już zdecydowanie bardziej.
Mamy oficjalne API Google, które pozwala wykonać full web search, czyli wyszukiwanie w całym internecie, i odebrać wyniki Google w JSON-ie.
Brzmi znajomo?
Trochę jak SerpApi.
Tylko bez proxy, CAPTCHA, emulowania przeglądarki i całej zabawy w kotka i myszkę z systemami antybotowymi.
Jest tylko mały haczyk.
Nie wystarczy karta kredytowa.
Google daje dostęp do normalnego wyszukiwania
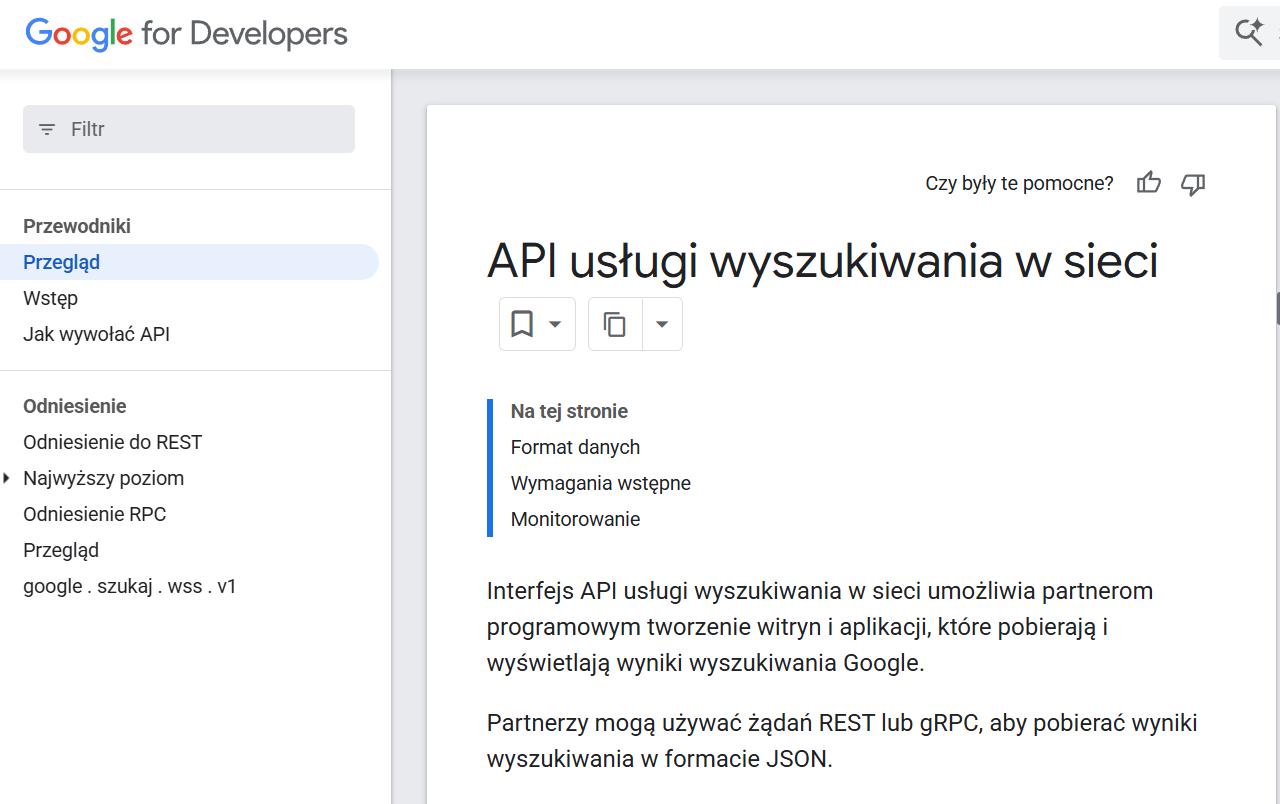
Samo API jest właściwie banalnie proste. Google udostępnia jeden podstawowy endpoint:
1 | https://websearchservice.googleapis.com/v1:search |
Wysyłamy zapytanie, Google robi wyszukiwanie i zwraca dane w JSON-ie. Można korzystać z REST albo gRPC. Dokumentacja wprost nazywa wykonywaną operację full web search.
To ważne, bo nie mówimy tutaj o wyszukiwaniu w naszej własnej bazie dokumentów ani o przeszukiwaniu kilku wskazanych stron. Nie jest to również API Search Console, które pokazuje statystyki dotyczące naszej witryny.
Pytamy Google:
1 | buty do biegania |
i dostajemy wyniki wyszukiwania Google.
W odpowiedzi mogą znaleźć się tytuł strony, URL, skrócony URL, snippet, typ MIME czy format pliku. Dostajemy również informacje o czasie wykonania wyszukiwania, szacowanej liczbie wyników oraz ewentualnej korekcie zapytania. Jedno wywołanie może zwrócić maksymalnie 20 wyników, domyślnie dostajemy 10, a kolejne strony pobiera się za pomocą tokena.
Czyli ktoś w Google naprawdę usiadł i przygotował:
oficjalny sposób na programatyczne odpytanie wyszukiwarki Google.
Dla ludzi siedzących w SEO od kilkunastu lat samo to brzmi trochę dziwnie.
Przez lata budowaliśmy proxy, parsowaliśmy HTML, rozwiązywaliśmy CAPTCHA, zmienialiśmy User Agenty, kombinowaliśmy z ciasteczkami i sprawdzaliśmy, po ilu zapytaniach Google zacznie pokazywać środkowy palec.
A tutaj nagle proszę bardzo.
JSON.
Tylko gdzie jest haczyk?
Na pierwszy rzut oka wszystko wygląda jak klasyczne API Google.
Potrzebujesz projektu w Google Cloud. Tworzysz API key. Wysyłasz go w nagłówku
1 | X-Goog-Api-Key |
.
Czyli standard.
Tyle że później pojawia się jeszcze jeden wymagany parametr:
1 | client_id |
I to nie jest zwykły identyfikator aplikacji, który wyklikujesz sobie w Google Cloud Console.
Google pisze, że zapytania są powiązane z partner agreement, czyli umową partnerską, a każde żądanie musi zawierać przydzielony partnerowi identyfikator klienta. Sam overview usługi zaczyna się zresztą od informacji, że API pozwala programmatic partners tworzyć strony i aplikacje pobierające oraz wyświetlające wyniki Google Search.
I to jedno słowo zmienia praktycznie wszystko:
partners.
To nie wygląda na API w modelu:
zakładam konto → podpinam kartę → kupuję milion zapytań.
Bardziej:
mam biznes → kontaktuję się z Google → Google akceptuje mój przypadek użycia → podpisujemy umowę → dostaję
.
Czyli API jest publicznie udokumentowane, ale dostęp do niego już publiczny nie jest.
API key to za mało
To jest chyba najważniejsza rzecz, bo widząc dokumentację na developers.google.com bardzo łatwo dojść do wniosku, że wystarczy utworzyć projekt w Google Cloud i można zaczynać.
Nie można.
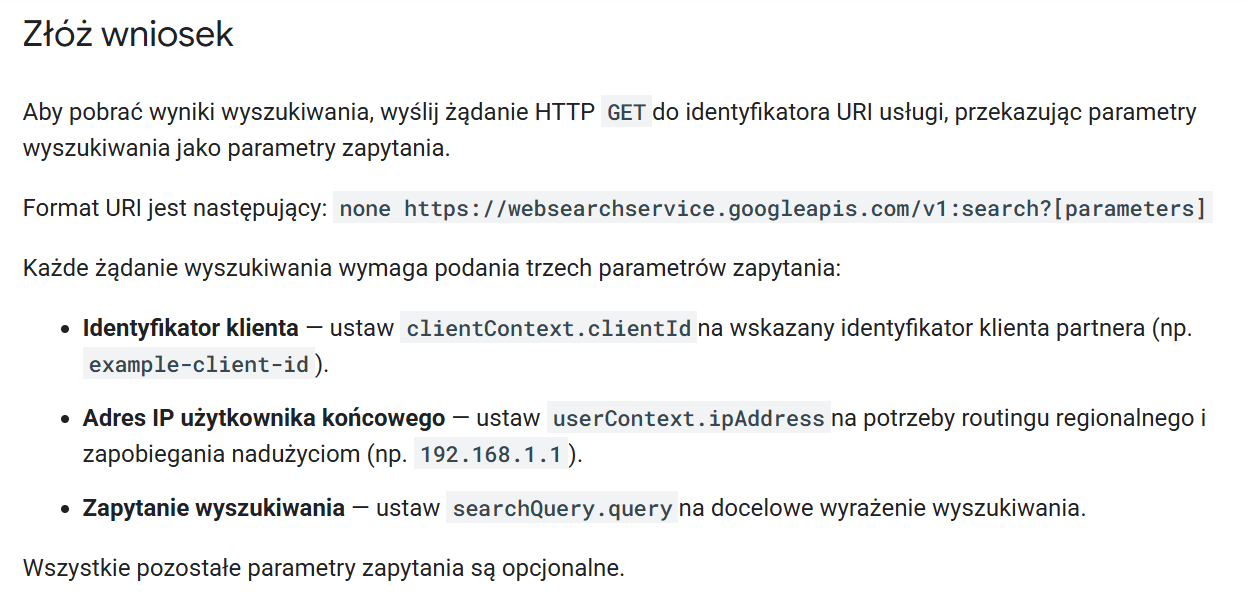
Do poprawnego zapytania potrzebujemy projektu Google Cloud i API key, ale również przypisanego przez Google identyfikatora partnera. Przykładowy format podawany w dokumentacji wygląda tak:
1 | partner-[name]-[product]-[feature set] |
Google pokazuje na przykład:
1 | partner-example-wss-standard |
Nie ma też publicznego cennika w stylu „5 dolarów za 1000 zapytań”.
Chcesz wiedzieć, ile kosztuje?
Porozmawiaj z Google.
Chcesz wiedzieć, jaki dostaniesz limit?
Porozmawiaj z Google.
Chcesz wiedzieć, czy Twój biznes w ogóle kwalifikuje się do programu?
No cóż.
Porozmawiaj z Google.
Jeszcze ciekawszy jest adres IP użytkownika
Jest w tym API jeszcze jeden detal, który moim zdaniem mówi o jego przeznaczeniu więcej niż pół strony marketingowego opisu.
Każde zapytanie wymaga podania trzech rzeczy:
1 | client_id |
, frazy wyszukiwania oraz adresu IP użytkownika końcowego.
Google podaje, że IP wykorzystywane jest między innymi do regionalnego kierowania zapytania i ochrony przed nadużyciami.
To jest bardzo ciekawe.
Jeżeli buduję zwykły rank tracker działający z crona, to kto właściwie jest użytkownikiem końcowym? Mój serwer? Klient, który trzy godziny później otworzy raport? Osoba, która sześć miesięcy temu dodała do monitoringu 40 tysięcy fraz?
Natomiast w modelu:
1 | użytkownik → moja aplikacja → Google API → wyniki → użytkownik |
wszystko zaczyna wyglądać zdecydowanie bardziej naturalnie.
Nie twierdzę, że wymaganie IP automatycznie zabrania używania API do monitoringu pozycji. Dokumentacja tego nie mówi. Jest to jednak dość mocna wskazówka, że Google projektuje tę usługę przede wszystkim jako źródło wyników wyszukiwania dla aplikacji obsługujących prawdziwych użytkowników, a nie jako hurtownię SERP-ów dla botów latających po milionach słów kluczowych.
I tutaj robi się naprawdę ciekawie z punktu widzenia SEO.
Czy można na tym zbudować monitor pozycji?
Technicznie?
Oczywiście.
Wysyłam frazę, ustawiam kraj i język, dostaję listę URL-i i sprawdzam, na którym miejscu znajduje się moja domena. API pozwala ograniczać wyniki do kraju i języka, filtrować je po czasie, używać SafeSearch czy sortowania po dacie. W samych zapytaniach mogą być również wykorzystywane operatory wyszukiwania Google.
Nie potrzebuję proxy.
Nie obchodzi mnie CAPTCHA.
Nie interesuje mnie, czy Google zmieniło klasę CSS przy tytule wyniku.
Nie muszę uruchamiać Chrome’a tylko po to, żeby przeczytać dziesięć linków.
Z punktu widzenia developera rank trackera brzmi jak wakacje.
Problem w tym, że pytanie nie brzmi:
Czy da się?
Pytanie brzmi:
Czy Google pozwoli używać tego API właśnie w taki sposób i na taką skalę?
A tego publiczna dokumentacja obecnie nie wyjaśnia.
Nie znamy również ceny. Nie znamy dostępnych limitów QPS. Nie wiemy, jakie wolumeny Google jest gotowe obsługiwać dla poszczególnych partnerów ani jakie dokładnie przypadki użycia akceptuje.
Przy 1000 zapytań dziennie może to nie mieć większego znaczenia.
Przy 100 milionach zaczyna mieć ogromne.
To nie jest jeszcze SerpApi od Google
Jest też druga ważna rzecz. Web Search Service API zwraca wyniki wyszukiwania, ale nie należy automatycznie utożsamiać ich z pełnym obrazem współczesnego SERP-a.
W publicznie opisanym schemacie pojedynczy wynik zawiera przede wszystkim tytuł, URL, snippet, MIME type i format pliku. Nie widzę tam osobnych struktur odpowiadających reklamom Google Ads, People Also Ask, Local Packowi, wynikom Shopping, Knowledge Panelom czy AI Overviews.
Dla klasycznego monitorowania pozycji organicznych może to wystarczyć.
Dla narzędzia, które ma dokładnie odtworzyć wygląd SERP-a i powiedzieć:
na górze były cztery reklamy, później AI Overview, następnie trzy organiczne wyniki, PAA i mapa
już niekoniecznie.
To istotna różnica między takim API a firmami zajmującymi się scrapowaniem całego SERP-a. SerpApi czy podobni dostawcy sprzedają nie tylko listę stron pasujących do zapytania. Ich produktem jest często również informacja o tym, co Google faktycznie wyświetliło użytkownikowi i w jakiej formie.
Google na razie dokumentuje coś bardziej przypominającego czyste wyniki wyszukiwania.
Przynajmniej oficjalnie.
A co ze starym Custom Search JSON API?
Tutaj pojawia się drugi element układanki.
Google ma już przecież Custom Search JSON API. Problem w tym, że usługa została zamknięta dla nowych klientów, a obecni mają czas na migrację do 1 stycznia 2027 roku.
Stary model był bardzo prosty. Dostawało się 100 zapytań dziennie za darmo, a kolejne kosztowały 5 dolarów za 1000 zapytań, maksymalnie do 10 tysięcy zapytań dziennie.
Teraz Google rozdziela zastosowania.
Jeżeli chcesz przeszukiwać maksymalnie 50 domen, firma proponuje inne rozwiązania, między innymi Vertex AI Search. Jeżeli natomiast potrzebujesz wyszukiwania w całym internecie, Google mówi mniej więcej:
skontaktuj się z nami i opowiedz, czego potrzebujesz.
W oficjalnym komunikacie dotyczącym zmian w Programmable Search Google wprost kieruje użytkowników potrzebujących „full web search” do kontaktu w celu uzyskania informacji o możliwościach i cenie nowego rozwiązania.
Trudno więc nie połączyć tych kropek.
Google wygasza łatwo dostępne API do wyszukiwania.
Google ogranicza model „search the entire web” w Programmable Search.
Google proponuje kontakt zainteresowanym pełnym indeksem.
A kilka miesięcy później mamy świeżo zaktualizowaną dokumentację usługi Web Search Service API, która wykonuje dokładnie full web search i wymaga identyfikatora wynikającego z umowy partnerskiej.
Google nie napisało wielkimi literami:
„TO JEST NASTĘPCA CUSTOM SEARCH JSON API.”
Ale kierunek wydaje się dosyć czytelny.
I teraz wróćmy do SerpApi
Kilka dni temu przy okazji sprawy Google kontra SerpApi pisałem, że prawdopodobnie zmierzamy do internetu działającego według zasady:
publiczne dla człowieka, płatne lub kontrolowane dla maszyny.
I nagle Google pokazuje oficjalną bramkę dla maszyn.
SerpApi pobiera wyniki Google w sposób, którego Google nie akceptuje. Google stosuje zabezpieczenia antybotowe. Trwa proces sądowy. Automatyczne pobieranie wyników jest coraz trudniejsze, a równocześnie Google rozwija rozwiązanie, w którym można te same wyniki dostać elegancko przez API.
Pod jednym warunkiem.
Google musi wiedzieć, kim jesteś.
I musi się na to zgodzić.
To jest zupełnie inny model internetu niż ten, do którego przywykliśmy.
Przez lata techniczna zasada była prosta. Jeżeli strona jest publiczna i potrafisz ją pobrać, to ją pobierasz. Najwyżej właściciel zacznie blokować Twoje IP i rozpoczynała się kolejna runda zabawy.
Teraz duże platformy coraz mocniej próbują stworzyć oficjalne wejście dla automatów:
1 | automat → umowa → API → dane |
zamiast:
1 | automat → HTML → parser → proxy → CAPTCHA → dane |
Dla użytkownika końcowego różnica praktycznie nie istnieje.
Dla firmy przetwarzającej 100 milionów wyników miesięcznie różnica jest fundamentalna.
Google nie musi wygrać wojny ze scraperami
To chyba najbardziej interesujący element całej historii.
Google wcale nie musi sprawić, żeby scrapowanie wyników stało się technicznie niemożliwe. To prawdopodobnie zresztą niewykonalne. Dopóki człowiek może wpisać frazę i zobaczyć wyniki, zawsze ktoś będzie próbował zasymulować tego człowieka.
Wystarczy jednak, że scraping stanie się odpowiednio drogi.
Więcej CAPTCHA. Lepszy fingerprinting. Powiązanie zapytań z sesją. Analiza zachowania użytkownika. Blokowanie centrów danych. Częstsze zmiany HTML. Kolejne challenge’e JavaScript.
Każda taka zmiana dokłada kilka groszy do tysiąca pobranych SERP-ów.
Przy małej skali nie ma znaczenia.
Przy setkach milionów zapytań robi się z tego bardzo duża faktura.
A wtedy po drugiej stronie pojawia się Google i mówi:
Po co się męczyć? Mamy API.
Tyle że to Google ustala cenę.
Google ustala limity.
Google ustala warunki.
I Google decyduje, czy w ogóle dostaniesz klucz do tej bramki.
Dla kogo właściwie jest Web Search Service API?
Na pewno nie wygląda to obecnie na produkt przygotowany dla człowieka, który napisał sobie skrypt w PHP i chce raz dziennie sprawdzić pozycje 500 fraz.
Dla takiego użytkownika cały proces partnerski byłby absurdalny.
Znacznie bardziej pasują tutaj duże serwisy i aplikacje, które chcą wbudować wyszukiwanie internetu we własny produkt, platformy researchowe, rozwiązania enterprise, być może produkty AI oraz inne firmy generujące odpowiednio duży i przewidywalny wolumen.
SEO również idealnie pasuje technicznie.
Nie wiemy jeszcze, czy równie dobrze pasuje biznesowo do tego, czego oczekuje Google od partnerów.
I właśnie odpowiedź na to pytanie będzie dla naszej branży najciekawsza.
Bo jeżeli Google zacznie zawierać umowy z dużymi dostawcami monitoringu pozycji albo hurtowniami danych SEO, możemy dostać oficjalne źródło wyników. Firmy nie będą musiały udawać milionów użytkowników przeglądarki tylko po to, żeby sprawdzić, czy domena spadła z pozycji trzeciej na piątą.
Jeżeli natomiast Google uzna masowe rank trackingi za zastosowanie, którego nie chce obsługiwać, nadal zostanie nam obecny rynek proxy i SERP API.
Tylko prawdopodobnie coraz droższy.
Największa zmiana nie jest techniczna
Sam Web Search Service API nie jest jakimś technologicznym cudem. To endpoint zwracający JSON. Programista ogarnie integrację szybciej niż ekspres zdąży zrobić drugą kawę.
Ciekawe jest coś innego.
Google zaczyna formalizować dostęp do czegoś, co wcześniej firmy brały sobie same.
Wyniki wyszukiwania od zawsze były publiczne. Otwierałeś przeglądarkę i je widziałeś. Jeżeli potrzebowałeś ich miliona, budowałeś większy automat.
Teraz coraz wyraźniej powstają dwa internety.
Pierwszy dla człowieka:
wpisz frazę i korzystaj.
Drugi dla maszyny:
przedstaw się.
powiedz, po co przyszedłeś.
podpisz umowę.
zapłać.
I dopiero wtedy możesz korzystać.
Nie twierdzę nawet, że jest w tym coś dziwnego. Utrzymanie infrastruktury kosztuje, a tysiąc zwykłych użytkowników wykonujących po trzy wyszukiwania to coś zupełnie innego niż jedna firma strzelająca milionem zapytań automatycznie.
Tyle że przez ostatnie dwadzieścia lat internet rozwijał się w dużej mierze właśnie dlatego, że najpierw ktoś brał publiczne dane i coś na nich budował, a dopiero później zastanawiano się nad regulaminami, API i modelem biznesowym.
Samo Google jest chyba najlepszym przykładem.
No i mamy bardzo ciekawą sytuację
Z jednej strony Google walczy z firmami, które automatycznie pobierają jego wyniki wyszukiwania.
Z drugiej strony ogranicza stare, łatwo dostępne API.
Z trzeciej tworzy oficjalne API do pełnego wyszukiwania, ale dostęp do niego przywiązuje do umowy partnerskiej.
Czyli problemem najwyraźniej nie jest samo to, że maszyna pyta Google.
Ważne jest:
czyja to maszyna, ile razy pyta i na jakich warunkach.
W sumie trudno się dziwić. Wyniki wyszukiwania stały się produktem potrzebnym już nie tylko SEO-wcom. Potrzebują ich systemy monitoringu, agregatory, wyszukiwarki specjalistyczne, systemy researchowe i przede wszystkim AI.
A jeśli coś jest potrzebne wystarczająco dużej liczbie firm, prędzej czy później ktoś postawi przy wejściu kasę fiskalną.
Google właśnie pokazało, gdzie może stać ta kasa.
Nie znamy tylko cennika.
Jeszcze.


Komentarze